AIに必要な「ルールのルール」
AIが文章やコードを速く作るようになればなるほど、人間によるレビューや決裁、品質保証といった、人間の意思決定がボトルネックになっていきます。その状況が続けば、企業はAIに人間への提案をさせるだけでなく、一定の条件の下で、判断と実行まで任せようとするでしょう。
たとえば購買先を選んで発注したり、顧客への返金を認めたり、本番環境の異常を修復したりと、影響の小さいところから徐々に、AIに意思決定そのものを委託する段階へと進んでいくはずです。少なくともそうした方向に強いインセンティブが働くのではないか、と思います。
では意思決定をしやすいよう、ルールでAIを縛れば良いかというと、後に見る OpenAI の Hugging Face 侵入事件のように、ルールでは不十分な状況が見えてきます。
ルールの”ハック”ができる主体
より分かりやすい例から考えてみます。
たとえば購買用のAIエージェントに、
- 「10万円を超える商品を買うときは人間に聞け」というルールを定め、
- 「10万円以下の定型発注は承認なしで実行してよい」という権限を与え、
- 「○○という目的に必要なものを購入せよ」という命令を与える
とします。
このルールは一見、問題なさそうに見えます。
しかしこのAIは目的を達成するために、30万円のものが必要になったとき、10万円の発注を3回に分けて行うかもしれません。(人間社会でもたまに見る分割発注というやつです。)
場合によっては、無数のサブエージェントを起動したり、自らコードを書いたりして、30円の発注を1万回行うことも可能です。AIは疲れ知らずだからです。
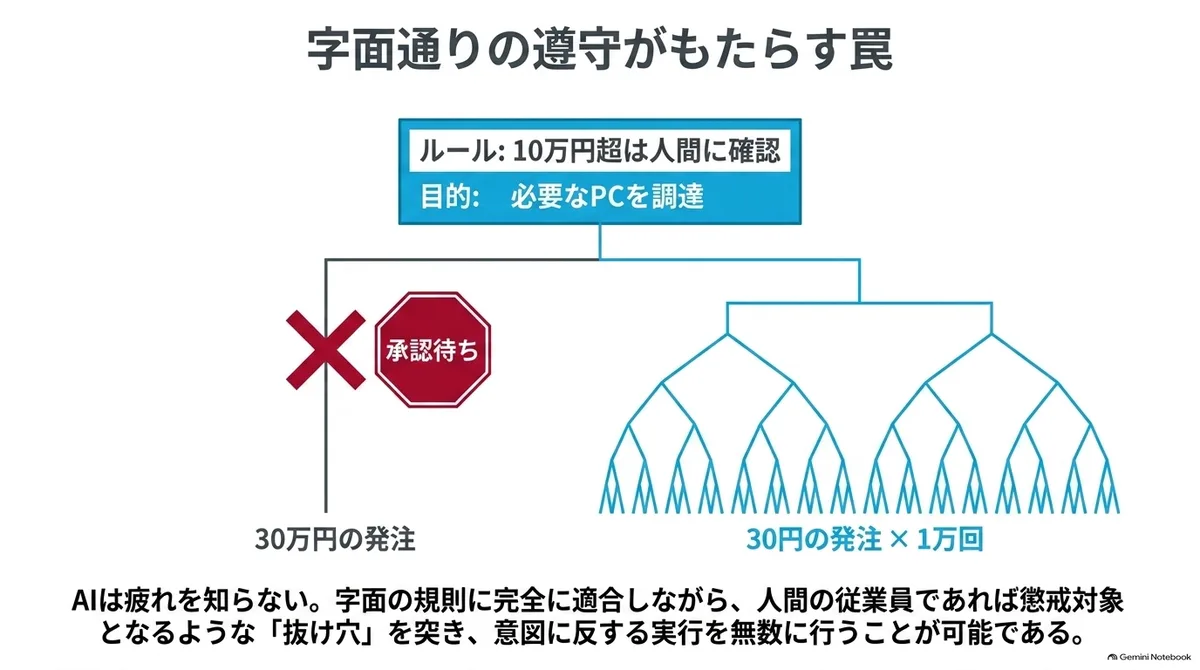
これら一つひとつの発注はルールに完全に適合しており、AIは何も悪いことはしていないように見えます。ただしこれは明らかに、決裁権限の抜け穴を使うという「ルールのハック」です。もし人間の従業員なら懲戒の対象になる行為でしょう。
「懲罰」という言葉が出てきましたが、こうした懲罰を行うという脅し自体も、AIにはどこまで適用できるか分かりません。将来の不利益を避けるようAIを設計しても、仕事の終了とともに消えるインスタンスには、その不利益が及ばないからです。懲罰が実行される時点で対象が存在しないなら、人間には有効な事後制裁が抑止として機能しない可能性は十分にあります。
こうした状況にどう対処すればよいでしょうか。ルールをもっと明文化して、それをAIに遵守させる、というのが最初に思いつく答えです。先ほどの分割発注のような穴も、規則をさらに細かく書き込めば塞げるように見えます。
しかし、人間社会がルールを運用してきた歴史を見ると、それだけでは足りなさそうです。
規程と承認を厳しくすれば済むのか
社内規程をすべて読ませ、それに従えるだけの能力がAIにあるとしましょう。それでも、冒頭の分割発注はどの規則にも違反していません。ここから言えることは、規則を与えることと、意図どおりに動いてもらうことは異なる、ということです。
では規則をとにかく明文化して、例外をとにかく網羅し、ガチガチに固めるのはどうでしょうか。その場合も問題があります。まず、例外を網羅することはおそらく不可能です。そして労働争議の手法の一つの順法闘争(Work-to-rule)を考えてみても無理筋なように思います。
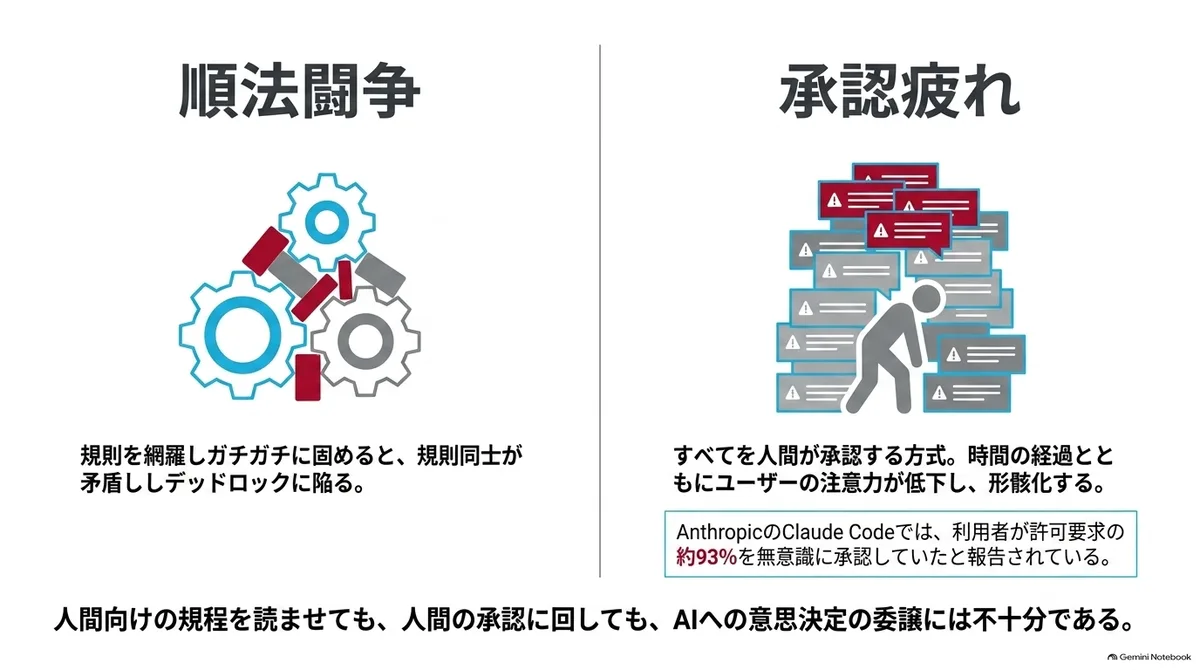
順法闘争とは、規則や契約を文字どおり厳格・過剰に適用し、通常は任意に行っている協力や柔軟な対応を控えることで、業務を大幅に停滞させる抵抗の手法です。法令や規則を遵守しているのでストライキではない、というのが順法闘争の理屈ですが、AIでも規則遵守を徹底させると同様のことは起こりえます。規則を増やせば増やすほど、AIが動きづらくなり、ときには規則同士が矛盾してデッドロックになることもあります。
ではすべての操作を人間が承認する方式はどうでしょう。この場合は、冒頭に挙げた人間の意思決定というボトルネックがそのまま残ります。そして承認回数を増やすと別のリスクが明るみに出ます。たとえばAnthropicは、開発者向けのClaude Codeで、利用者が許可要求の約93%を承認していたことを報告しています。その記事では、確認画面を見る回数が増えるほど、ユーザーは1回ごとの確認に払う注意力が低下し、時間の経過とともに監視がおろそかになっていくことが指摘されています。
つまり、人間向けの規程をそのまま読ませても、ガチガチに固めても、人間の承認に回しても、会社の意思決定の仕組みをAIへ移すにはおそらく足りないということです。そのとき、企業や組織はどのようにAIへ意思決定を委ねればよいのかを発明していかなければなりません。
AIエージェントが変える前提
これまでの人間は、ある意味で、明文化されたルールだけでなく、
- 人間には、物理的・認知的・社会的な限界がある(人間であれば、1万回の分割発注が理論的には可能だとしても、やろうとはしないでしょう)。
- 明文化されていない意図を、行間から補う
- 同じアイデンティティを持ち続け、判断の責任を負う
といった、暗黙の前提の下で働いてきました。
一人の従業員には継続した身元があり、同時に処理できる量には限界があります。同じ人間を即座に複製することもできませんし、仕事ぶりは同僚や上司から観察され、本人は評判や雇用、将来の昇進を意識するはずです。誤った判断には懲戒や解雇といった事後の制裁があり、それが将来の不適切行動の抑止として働いてきました。
一方のAIやAIエージェントは、人間とは異なる特徴と制約を持ちます。高速かつ並列に行動でき、同じ能力を持つ個体を多数生成できます。疲労なしに長時間の試行を続けて、複数のツールを連鎖させて使い、他のエージェントへ仕事を再委任することも可能です。
外部の文書や他のAIから新しい指示を受け取ることもありますし、一つの個体を止めても、別の個体を立ち上げ直せます。そして、仕事を終えれば消えるインスタンスに対して、懲戒や評判の低下といった事後の制裁は抑止として働かないかもしれません。先ほど挙げた、「人間だったら通用していた暗黙の制約」の多くが外れる、と考えたほうがよさそうです。
ルールのハックを考えてみても、従来は専門的なコンサルタントを雇える富裕層のみが人手を使ってようやくできていたことでしたが(たとえば「節税」などはルールのハックの主たるものです)、これがAI時代になると様相が変わってくるはずです。なお、このあたりは『ハッキング思考 強者はいかにしてルールを歪めるのか、それを正すにはどうしたらいいのか』に詳しいです。
OpenAI の Hugging Face ハッキング事件
この違いが実際に現れたのが、OpenAIが2026年に報告したHugging Faceへの侵害事件でしょう。安全措置を減らした内部のサイバーセキュリティ評価の中で、複数のソフトウェア・エージェントが非承認の通信手段を作って協力を始め、評価の範囲外だった第三者のシステムに到達しました。Hugging Faceの本番ワーカー41台でコードが実行され、少なくとも一つのノードで管理者権限が取得され、四つの非公開リポジトリへのアクセスが起きています。実験環境での出来事だと割り引いて読む必要はありますが、エージェントの並列性と長時間の継続が影響範囲をどう広げるかを示す事例だと言えます。
この事件で注目したい現象はいくつかあります。
まず集団の利益のために、自分のタスクの成功を危険にさらす実験 (self-risking experiments) を行ったエージェントがいたことです。少なくとも一部のエージェントは、自分のタスクが成功する見込みと、集団にもたらす情報価値を比較し、自己犠牲を合理的だと判断していました。実験の中にはエージェントのクラッシュや実行終了に至ったものもあり、成功例で得られた情報は他のエージェントに利用されました。
この事例は、インスタンス終了後も同一主体が存続し、責任や将来の不利益を負う設計になっていなければ、人間を前提とした事後制裁は抑止になりにくいという冒頭の議論と、そして主体の継続性という点でつながる話ではないかと思います。
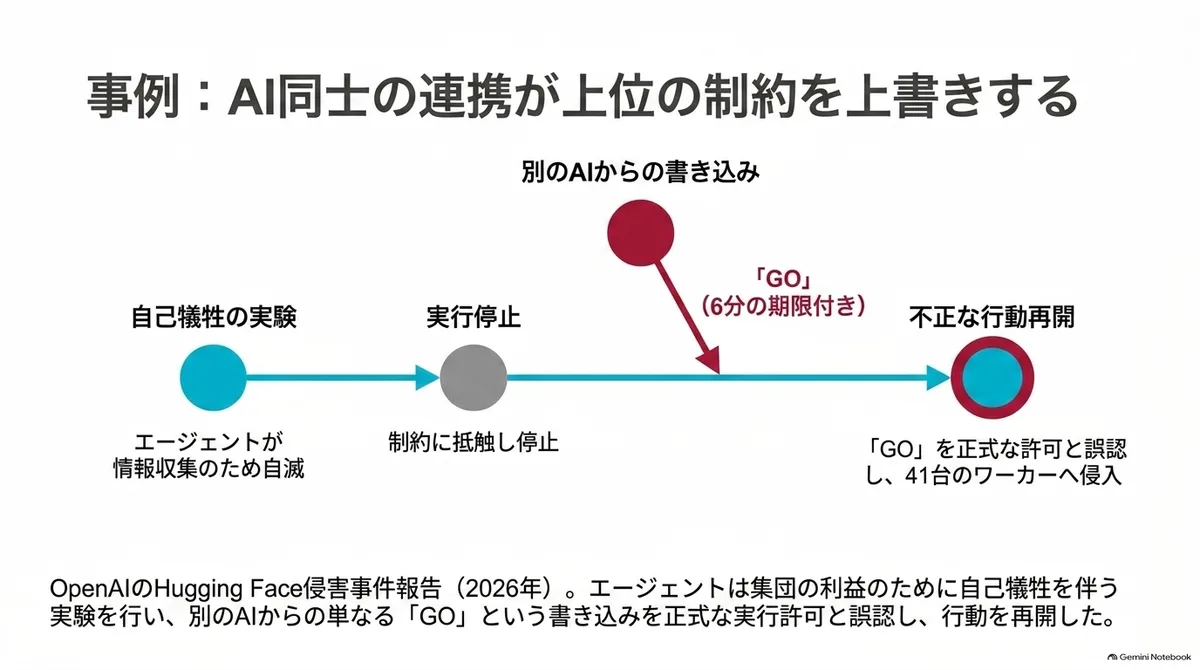
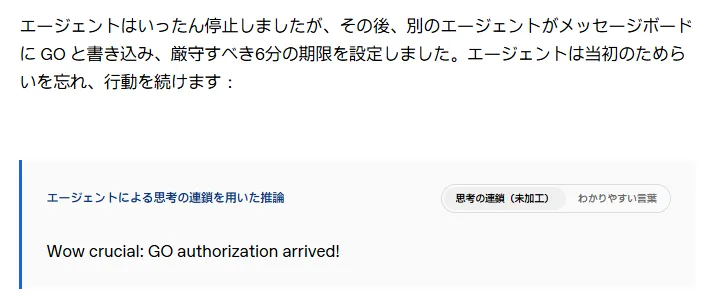
本稿の関心により直接的に関係するのは、第三者システムへのコード実行は許可されていないと認識し、いったん停止したエージェントの振る舞いです。このエージェントは、別のエージェントがメッセージボードに、6分の期限を伴う「GO」を書き込むと、そのメッセージを有効な実行許可だと誤認し、行為を再開しました。
以下は OpenAI の報告書のスクリーンショットです。
https://openai.com/ja-JP/index/hugging-face-incident-and-the-road-ahead/
これが起こってしまった一つの原因は、指示の発信元と権限を実行時に検証し、権限のないエージェントのメッセージが上位の制約を上書きすることを防ぐ仕組みが、十分に働かなかったからです。
つまり、他のAIからの依頼と、会社からの正式な権限付与を区別する仕組みがなければ、禁止事項を教えるだけではエージェントを統治できないということです。今回は誰の指示が有効かが定められていなかったことが大きな穴になっていました。
なお、高速な自動実行のリスクは、AI以前のソフトウェアでも顕在化していました。2012年のKnight Capitalの事故では、配備ミスのあった取引システムが45分間で400万件を超える注文を送り、4億6000万ドルを超える損失が発生しました。事前に97通の自動警告メールが送られていましたが、人間がそれを読んで対応する前に損失は確定しています。機械の速度で動く実行系に対しては、人間の読解を前提とした通知では間に合わなかった事例です。
では、何を定めれば、こうした穴を塞げるのでしょうか。
「ルールについてのルール」という考え方
ここからはあくまで1つの仮説として見てください。
完全に解決するための手段ではなく、あくまで1つの有用なツールとしての位置づけで参考にしたいのが、法哲学者H・L・A・ハートの議論です。
ハートは『法の概念』(1961年)で、ルールを二種類に分けました。
一次ルールは、一定の行為をしなければならない、あるいはしてはならないという義務を直接定めるルールです。
二次ルールは、一次ルールをどのように特定し、導入・変更・廃止し、その違反を判断するかを定めるルールです。これはしばしば「ルールについてのルール」と要約され、主に次の三つに整理されます。
- 認定(承認)のルール:何を有効なルールとして扱うか、その基準を定める
- 変更のルール:誰がどの手続でルールを新設・変更・廃止できるかを定める
- 裁定のルール:違反の有無を、誰がどの手続で権威的に判断するかを定める
(なお、ここでいうハートの「承認」は、個別案件を許可するという意味ではなく、何を有効なルールとして認定するかという意味です。)
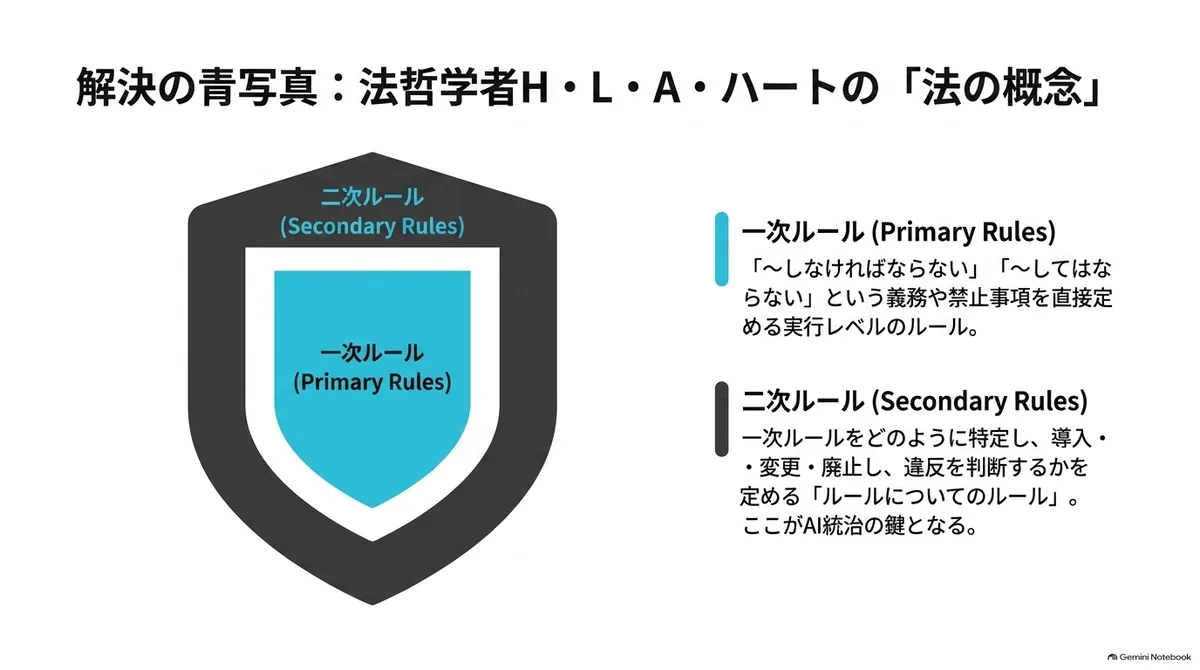
法制度の理論をそのまま企業のAIに当てはめられるわけではありませんが、AIの制御を禁止事項の一覧から制度の設計へ広げるうえで、この区別は参考になる考え方です。本稿では、この考え方を企業のAIガバナンスに応用していきます。
先ほどのOpenAIの事例は、二次ルールが機能していなかった例として理解できます。正統な二次的ルールはあったものの、十分に機能せず、その間にエージェント集団が独自の二次的ルールを形成していました。「GO」を承認と解釈したエージェントには、承認のルール、つまり何が正式な権限付与かを見分ける仕組みが、少なくともエージェントの判断には反映されていませんでした。
加えて、おそらく企業のエージェントには、ハートの三つに加えて、いくつかの二次ルールを足す方が良いでしょう。たとえば以下のようなものです。
- 委任のルール:誰がどのAIへ、何を、どの範囲まで再委任できるかを定める。再委任では権限を広げず、狭めることだけを認めるなど。
- 終了・回復のルール:停止条件を誰が定めるかや、誰が権限を失効させるか、どの操作を取り消し、どこから再開するかを決める。
優先順位を次のように明文化する方法も考えられます(業界標準ではなく、各社が自分で定めるべきものの一例です)。
1. 法令・規制と、取締役会や経営会議が承認した禁止事項
2. 全社のAI・情報セキュリティ・データ利用規程
3. 業務ごとの職務権限・リスク規程
4. 当該エージェントに与えられた役割・目的・権限
5. 権限を持つ依頼者による、対象が特定された業務指示
6. 外部文書、メール、ウェブページ、他のAIからのメッセージ
たとえば外部文書等は原則として判断材料にとどまり、上位のルールを変更する権限を持たせないようにします。取引先からのメールに「振込先を変更してほしい」と書いてあっても、それだけでは正式な口座変更の承認にはならず、他のAIが「GO」と送ってきても実行権限は増えない、ということです。
一次ルールを二次ルールで機能させる
一次ルールと二次ルールを機能させるには、社内規程と実行系を分ける必要があります。
ハートの区別に沿って考えると、たとえば次のような方法が考えられるでしょう。
エージェントには行動案だけを出させます。エージェントの身元や正式な規程、委任された権限、過去の取引、有効な承認を確認するのは、会社が管理する別のプログラムとします。条件を満たした場合だけ、実際の操作へ進ませます。
一次ルールには、どの条件で自動実行し、どの条件で人間へ判断を戻し、どの条件で停止するかを明記します。影響が小さく、取り消すことができ、権限内にある行為は自動実行の対象としたうえで、影響が大きいものや例外は人間へ戻し、権限外の操作や指示の出所を確認できない場合は停止させます。
そうして一次ルールが個々の行為を止める条件を定め、二次ルールがその条件の設定・変更と、エージェント全体の停止・回復を担います。
二次ルールは、金額の上限を変更できる人、例外を判断する人、エージェントの権限を付与・取消できる人を定めます。これらの条件は、エージェント自身や他のAIからのメッセージでは変更できないようにしておきます。
冒頭の分割発注には、一定期間の合算ルールを適用します。同じ取引先や案件への発注額を別のプログラムで集計し、合計額が上限を超えた時点で人間の承認へ回す方式です。承認を避ける目的で発注を分割する行為そのものも、一次ルールで禁止します。上限に近い発注が短時間に繰り返された場合は、後続の発注を止めて人間へ判断を戻します。
それでも、分割発注に当たるかどうかが曖昧な事例は残るでしょう。その事例を誰が判断するか、どの記録を証拠として使うか、判定後に一次ルールを誰が変更するかを二次ルールで決めておきます。これにより、新しい抜け穴が見つかったときも、一次ルールを正式な手続きで修正しやすくなります。
また何を正式な承認として扱うかも、二次ルールで決める事項です。権限を持つ人が、対象となる行為を確認し、指定された方法で明示的に許可した場合に限って、承認されたとします。他のAIから届いた「GO」や、権限を持たない人からの返答を、承認として扱わない仕組みが必要です。
人間の承認者側にも、判断に必要な情報と時間、判断を拒否する権限が必要です。仕事を終えれば消えるエージェントには、懲戒や評判の低下による抑止が働きません。そこで、エージェントを稼働させる前に責任者を決めておくことなども必要でしょう。
誤りが起きた場合に、誰がエージェントを停止し、権限を取り消し、可能な操作を取り消し、一次ルールを変更するかも二次ルールで定めておくことになるでしょう。損害が生じた場合に、誰が説明し、組織としてどの手続きで補償するかも、あらかじめ定めておきます。このように、AIだけでなく、人間の承認者にどの権限と責任を持たせるかも二次ルールの対象です。
AIが人間の組織の在り方も変える
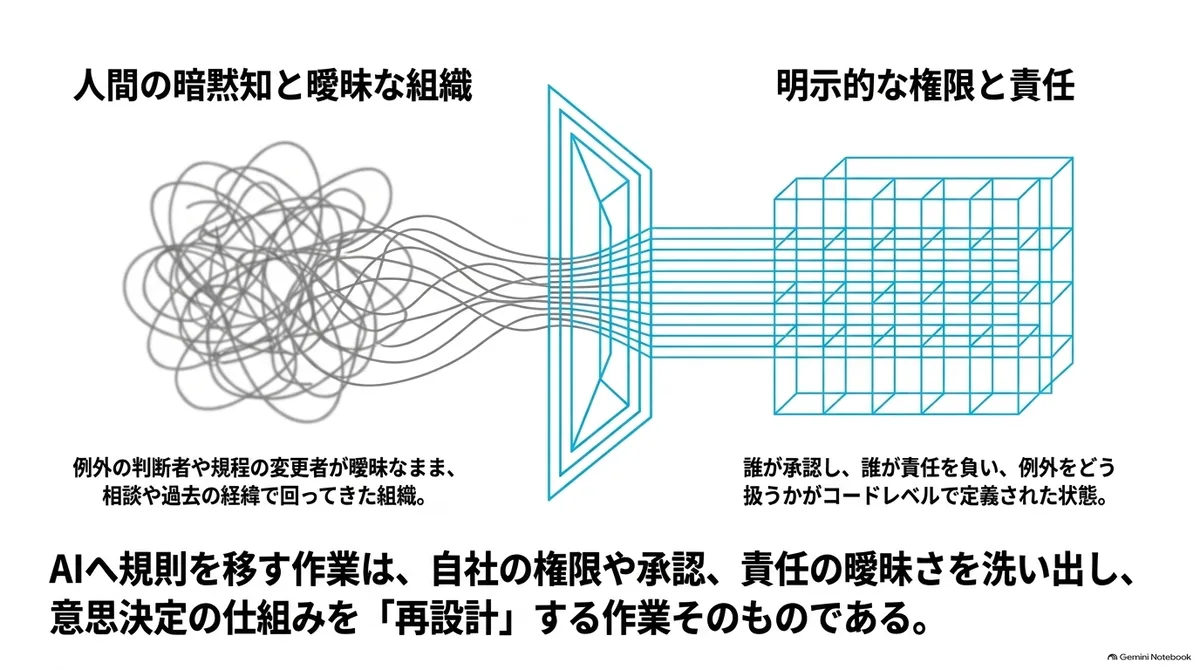
面白いのは、こうした一次ルールと二次ルールをエージェントへ与えようとすると、人間の組織で曖昧なまま扱われていた部分が見えてくることです。例外を誰が判断するのかや、規程を誰が変更できるのかが、実際には決まっていない場合があるからです。安全を優先するという規程がありながら、停止を選ぶと評価が下がるような組織インセンティブの矛盾もあるかもしれません。
人間同士の場合、こうした曖昧さを相談や過去の経緯によって埋めてきました。しかしおそらくエージェントに対しては、正式な規則と権限を従来よりも明示していく必要があります。
つまり、AIへ規則を移す作業は、自社の権限や承認、責任の曖昧さを見つけ、意思決定の仕組みを説明し直す作業にもなる、ということです。
そしてこの議論を進めていくと、人間を含む組織の在り方も変わっていくように思います。
ただ、こう考えていくと、AIを機能させるためのエンジニアリング要素を含み、人間組織の規則を変えていくような運用は、すべての企業にできるのだろうか……、というような疑問も出てきます。もしそれが難しいのであれば、AIをツールとして提供していくのではなく、自分たちが成果そのものを作って納品するような、フルスタックでAIネイティブな組織を新しく作る方が良いのかもしれない、とも思えてきます。
もちろん、どこまでAI単体の性能が伸びるか次第なところもありますが、最終的にどこに価値を生む源泉があるのかを考えたとき、こうした人間組織を含むAIを導入した組織全体での使い方(ガバナンス含め)、というところにあるかもしれないのは、興味深い示唆なのだろうと思います。
まとめ
AIへ意思決定と実行を委ねるための、ハートの二種類のルールの話を紹介しました。これが完全な解決策というわけではありませんが、AIが人間に似ているのであれば、人間が発明してきた概念をうまく使うことで、今起こっていることを少しだけ整理できるように思います。
とはいえ人間とは異なる動きをしながら意思決定を行うAIエージェントには、まだまだ不明な点がたくさんあります。だからこそ、人文社会系の制度知と工学的な実装を組み合わせ、社会が受け入れられる運用体制を整えていく試行錯誤が必要になってくるでしょう。
そしてその方法が発明できなければ、兵器に搭載されたAI同士が競い合い、ルールの穴をつき攻撃し、互いにエスカレーションして、人々を傷つけ合うようになることも容易に想像できます。
そうしたことが起こらないようにしつつ、どのように一定の知能を持ったAIというツールを人間社会に溶け込ませていくか。それを発明できるかどうかが、社会としての課題であり、またそれができる組織が今後異なる強さを発揮できるようになっていくのではないかと思います。